
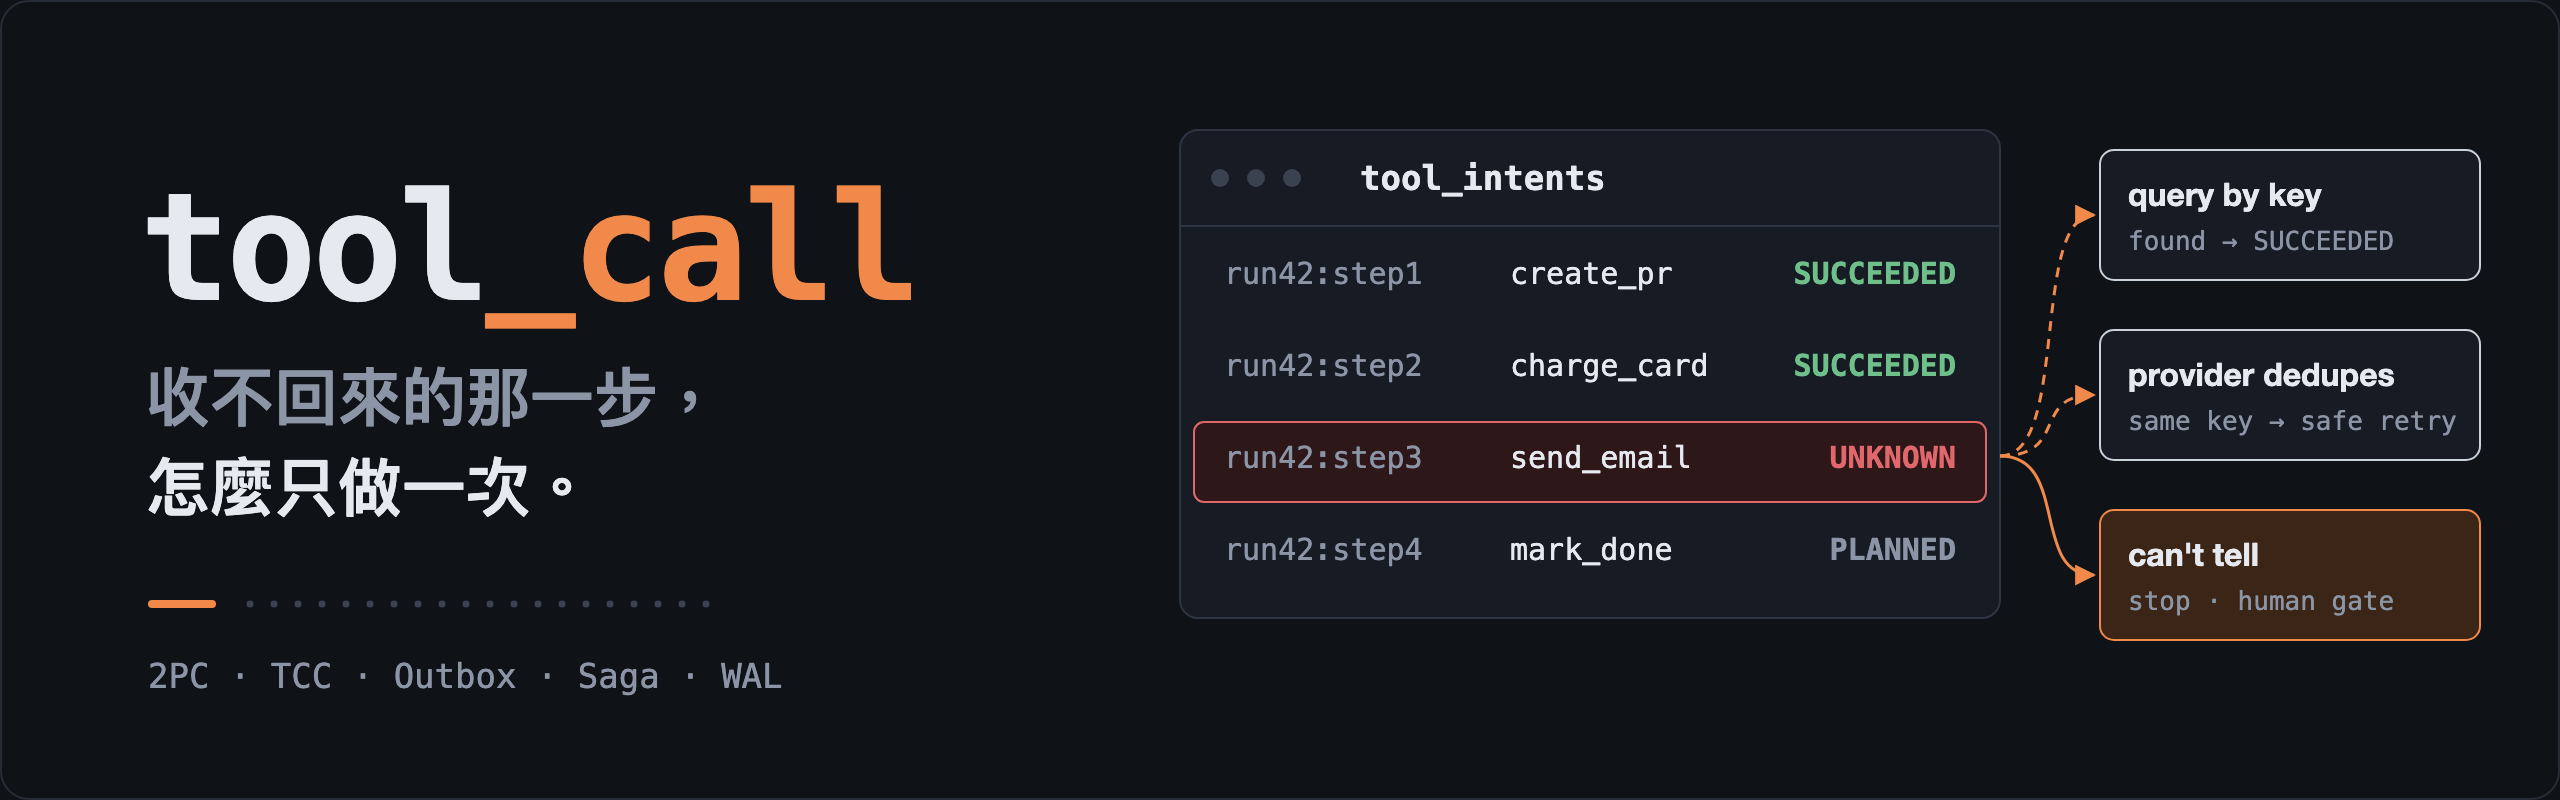
最近在做自己的 agent ops 系統。設計 loop 和 tool_call 的時候,想到以前遇過的類似問題:
萬一這個 tool_call 發出去,是沒辦法回滾的操作呢? 寄出去的信收不回,付出去的款要等退款,刪掉的資料可能已經沒有備份。那要怎麼保證它只做一次?
這個問題我不陌生。過去設計金融交易系統時,幾乎每天都在處理它,大致可以歸納成四件事:
- 不能重複扣款:同一筆請求,就算因為網路重送、重試而來好幾次,也只能生效一次。
- 必須能回滾或補償:做到一半失敗,已經做完的步驟要能被撤回,或至少有人能把它們收拾乾淨。
- 要用唯一 key 來查詢與保證:每一筆操作都要有識別碼,才能去問「這筆到底有沒有成功」。
- 查不到的時候要人工介入:有些狀況系統自己判斷不了,就該停下來交給人。
把這四件事套到 tool_call 上,本質上就是一個高風險操作。所以我的第一個反應是:這類操作必須放一道 human review 的關卡。
但如果真的要讓系統自動執行,又該怎麼把傷害降到最低?這個問題讓我想起分散式系統裡三個常見的設計 pattern。這篇就當作複習,順便看看它們跟 agent 的關係。
先說清楚:exactly-once 在哪裡做得到
在開始之前要先修正一個常見的說法。在不可靠的網路上,「傳遞恰好一次」(exactly-once delivery)基本上做不到。請求可能送到了但回應丟失,你不知道對方有沒有做。
真正能做到的組合是:
- at-least-once:確保操作至少會被執行一次,失敗就重試。
- 冪等(idempotent):同一個操作執行多次,效果等同於只執行一次。
兩者加起來,得到的是「效果上恰好一次」(exactly-once processing)。換句話說,重點不是讓訊息只送一次,而是讓「送多次」也不會出事。這個觀念會貫穿後面三種 pattern。
2PC:兩階段提交
2PC(Two-Phase Commit)是最直覺、也最強的原子性做法:
- Prepare 階段:協調者(coordinator)問每個參與者「你能不能做?」參與者如果同意,就把資源鎖住、把 prepare 紀錄寫進持久化的 log,再回覆 yes。回了 yes 就是一個承諾:之後只能照協調者的決定 commit 或 abort,不能自己反悔。
- Commit 階段:如果全部都 yes,協調者通知所有人 commit;只要有一個 no,就通知所有人 abort。
它的優點是所有參與者要嘛全部成功、要嘛全部不成功,中間狀態不會被外部看到。傳統資料庫的 XA 協定就是這個模型。
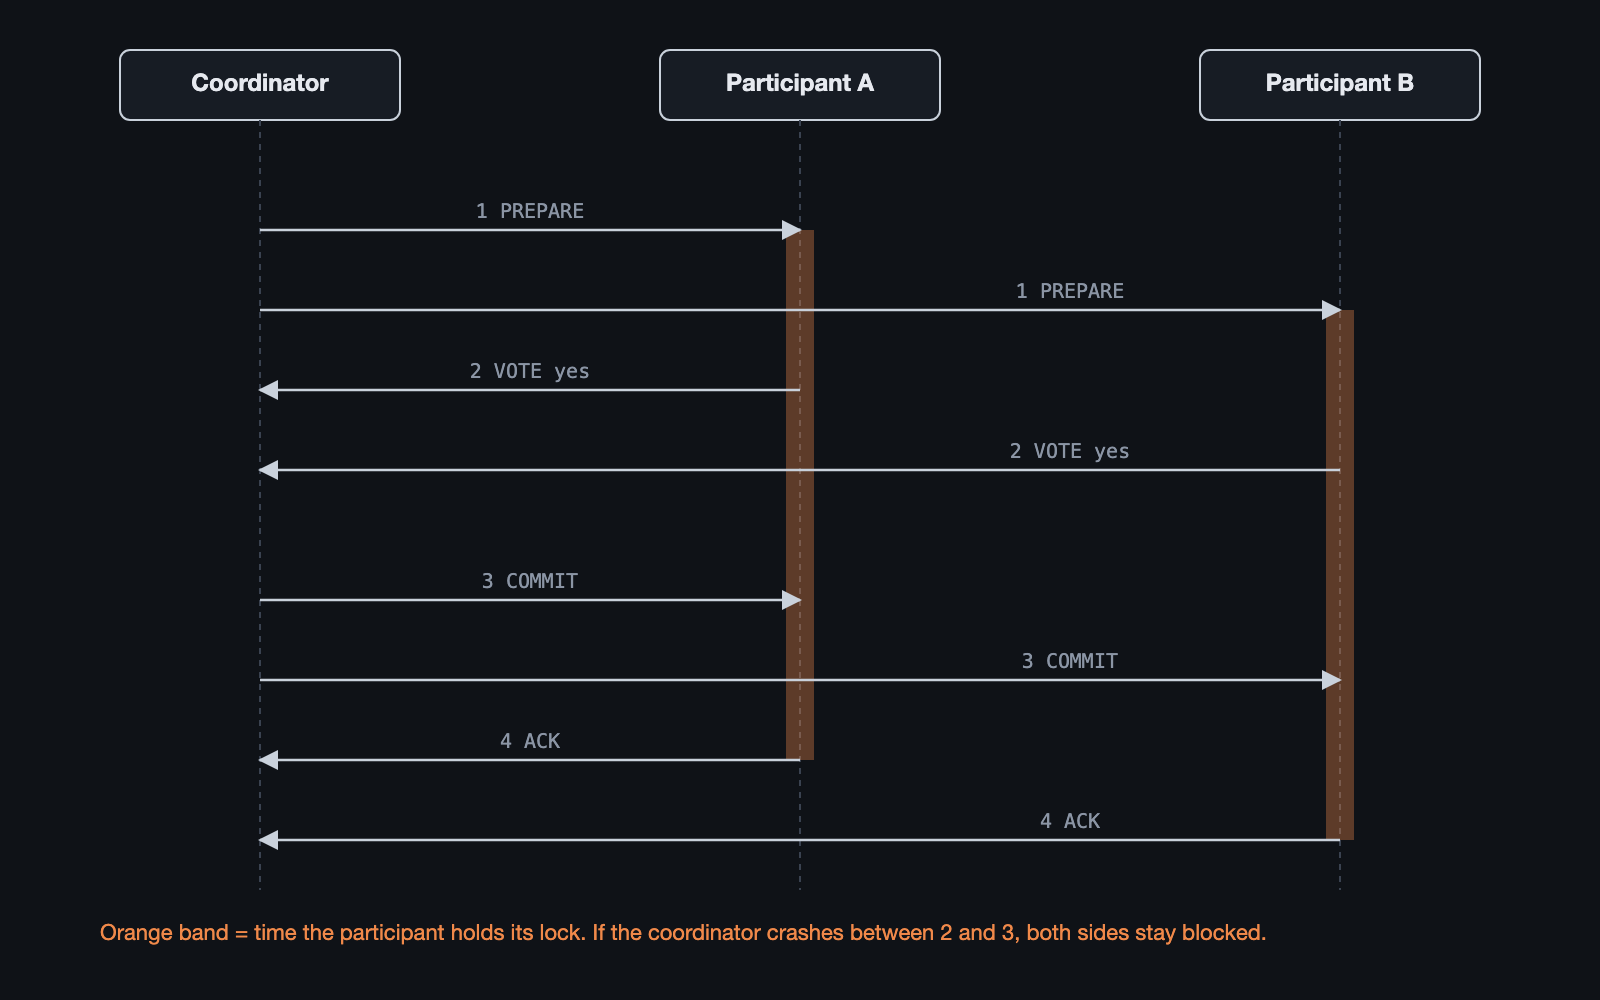
但它的代價也很明顯:
- 協調者掛掉的時候,參與者會卡住。 它們已經 prepare 完、鎖住資源,又承諾過不能自己 abort,不知道該 commit 還是 abort,只能等。鎖會一直持有,影響其他交易。
- 每個參與者都要支援 prepare。 資料庫可以做到,但外部的 HTTP API 通常不行。
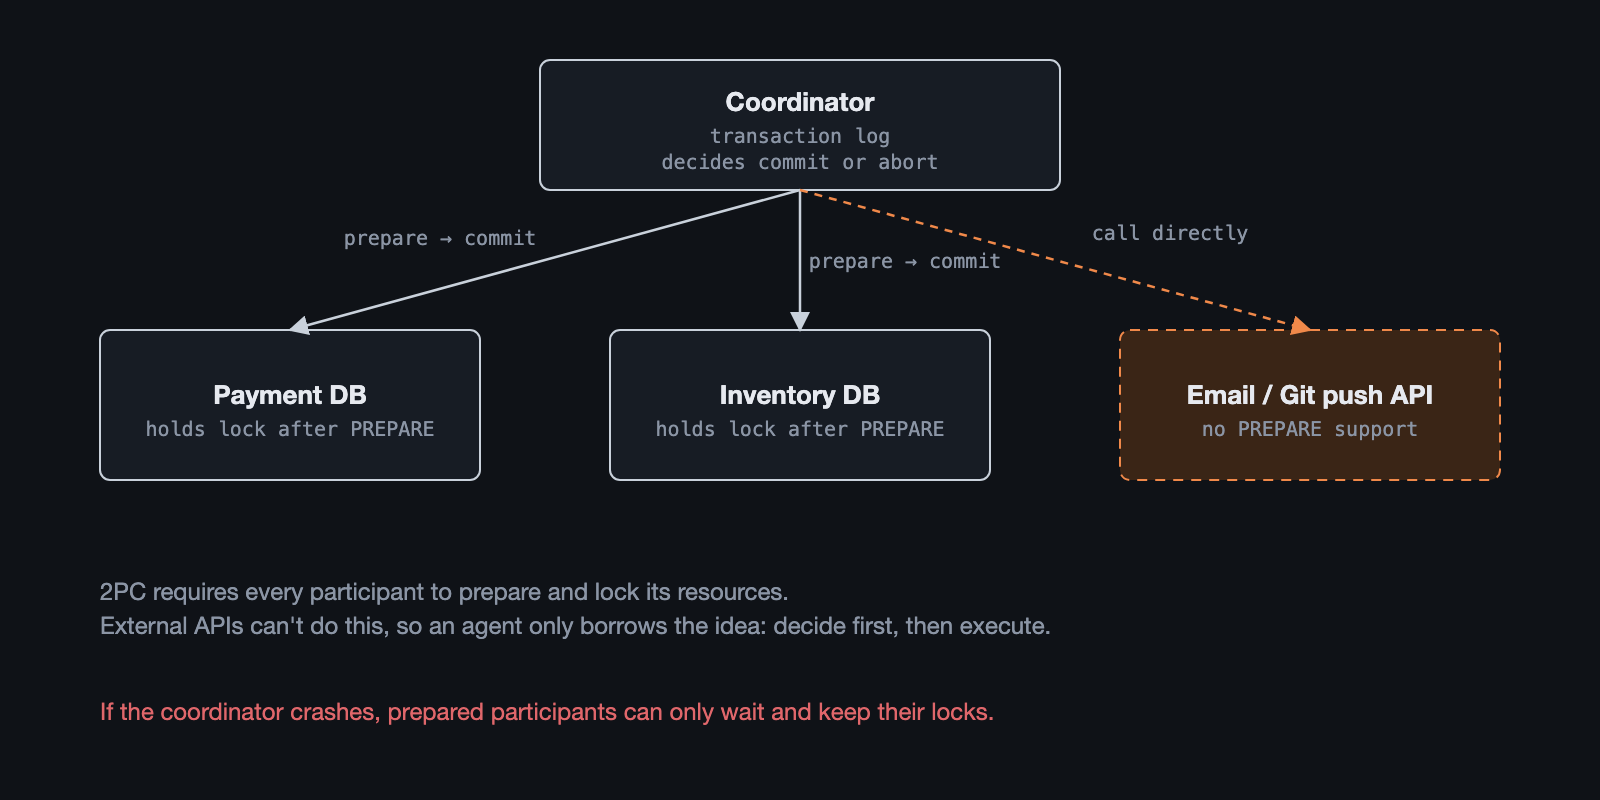
套到 tool_call 上,問題就出在這裡。寄信的服務、付款的 API、Git 的 push,幾乎沒有一個提供 prepare。你沒辦法「先鎖住 Gmail 寄信的權利,等全部準備好再一起寄」。所以 2PC 本身不太適用,但它的思路還是有用:把「要不要做」和「真的做」拆開,前者可以先驗證、先 dry run。
TCC:自己在業務上做一個 prepare
外部 API 不給 prepare,那就在業務層自己做一個。這就是 TCC(Try-Confirm-Cancel),可以把它看成業務層級的 2PC:
- Try:先把資源預留起來,但還不生效。例如信用卡先授權(hold 住額度,還沒請款)、信先存成草稿或排程、資料先 soft delete。
- Confirm:所有 Try 都成功之後才確認:真的請款、真的寄出、真的清掉資料。
- Cancel:只要有一步 Try 失敗,就取消已經預留的部分:void 授權、刪掉草稿、還原 soft delete。
Cancel 跟後面 Saga 的補償很像,差別在時間點。Try 階段外部還看不到效果,所以 Cancel 幾乎等於 rollback。信用卡授權被 void 掉,帳單上什麼都不會出現;如果已經請款了,就只能退款,帳單上會留下兩筆。同樣是「取消扣款」,做的時機不同,性質就不同。
實作上有幾個地方要注意:
- Confirm 和 Cancel 都可能被重送,兩者都要冪等。
- Cancel 可能比 Try 先到。例如 Try 逾時、協調者決定取消,結果 Try 晚一步才送達。所以要把已經取消的 key 記下來,晚到的 Try 直接拒絕,不然會留下一筆沒人處理的預留。
- 預留通常有期限。授權 hold 會過期,草稿可能被清掉,Confirm 要在期限內完成。
TCC 的價值在於把真正不可逆的時間點縮到 Confirm 那一刻。在那之前出錯,都還能乾淨地收回來。
Outbox:讓本地狀態跟事件保持一致
Outbox 解決的是另一個更日常的問題:寫 DB 和發訊息是兩件事,無法放在同一個原子操作裡。
最常見的錯誤寫法是:
11. 寫入 DB:訂單狀態改成 paid   ✅
22. 發送 event:order.paid        ❌ 這裡掛掉
結果是 DB 說已付款,但下游永遠收不到通知。反過來先發事件再寫 DB,也會出現「通知了但狀態沒改」的情況。
Outbox 的做法是:把要發的訊息也當成資料,跟業務資料寫在同一個本地 transaction 裡。
1BEGIN;
2  UPDATE orders SET status = 'paid' WHERE id = 42;
3  INSERT INTO outbox (id, aggregate_id, type, payload, status)
4    VALUES (gen_random_uuid(), 42, 'order.paid', '{"order_id": 42}', 'PENDING');
5COMMIT;
接著有一個獨立的 relay 程序,不斷撈 PENDING 的紀錄、發送到 message broker,發送成功之後再標記為已送出。因為業務資料和 outbox 在同一個 transaction 裡,要嘛兩者都寫入、要嘛都沒有,不會再有不一致。
relay 不一定要輪詢資料表。另一種常見做法是用 CDC(Change Data Capture,例如 Debezium)直接讀資料庫自己的 WAL,看到 outbox 有新的列就發出去。這篇以輪詢為例,因為 agent 的場景比較容易自己實作。
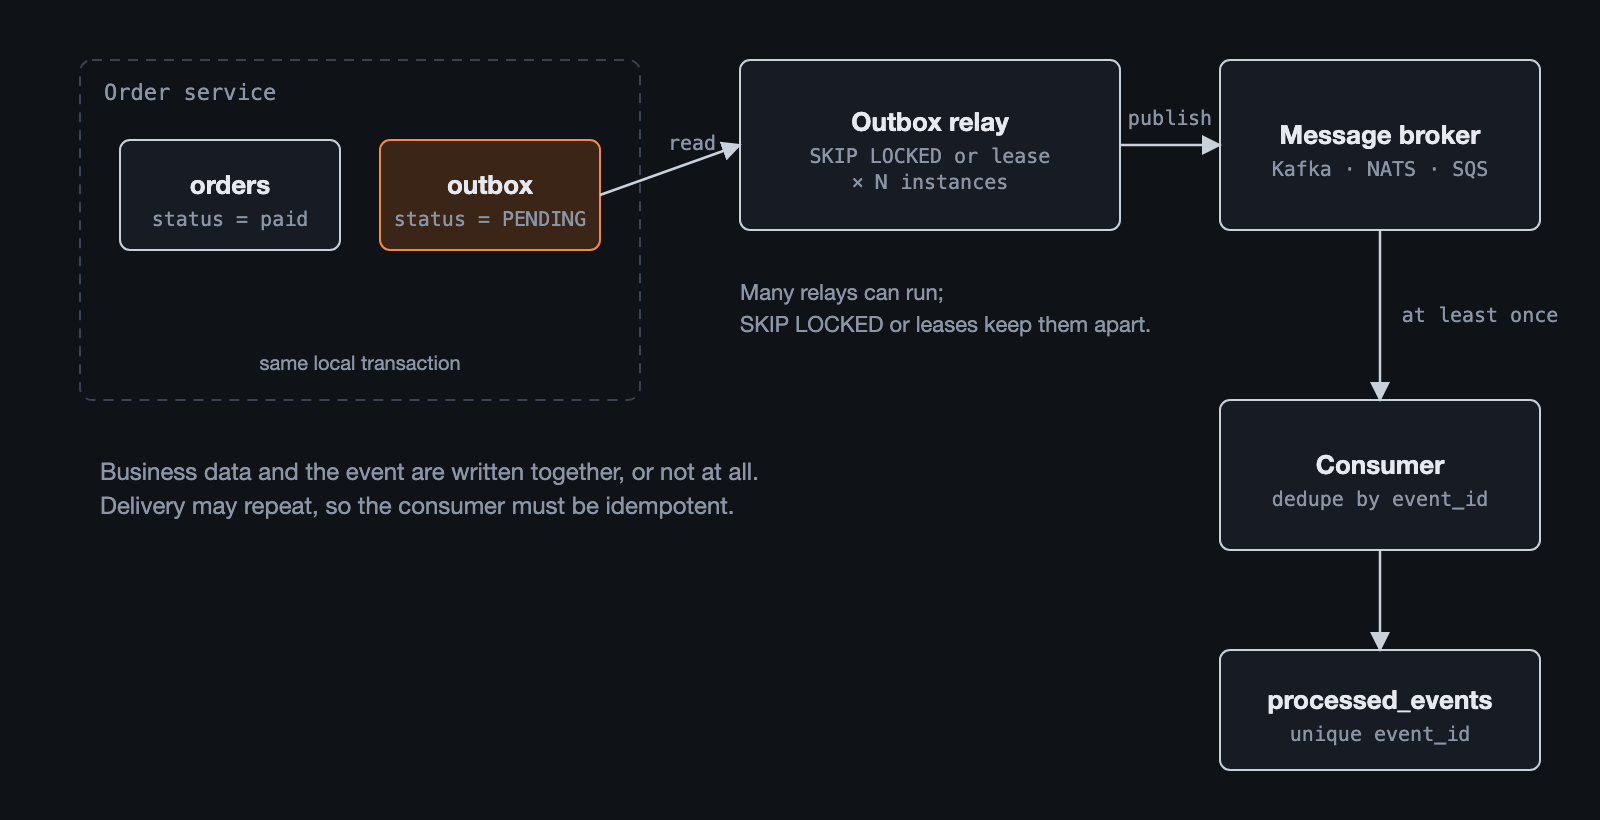
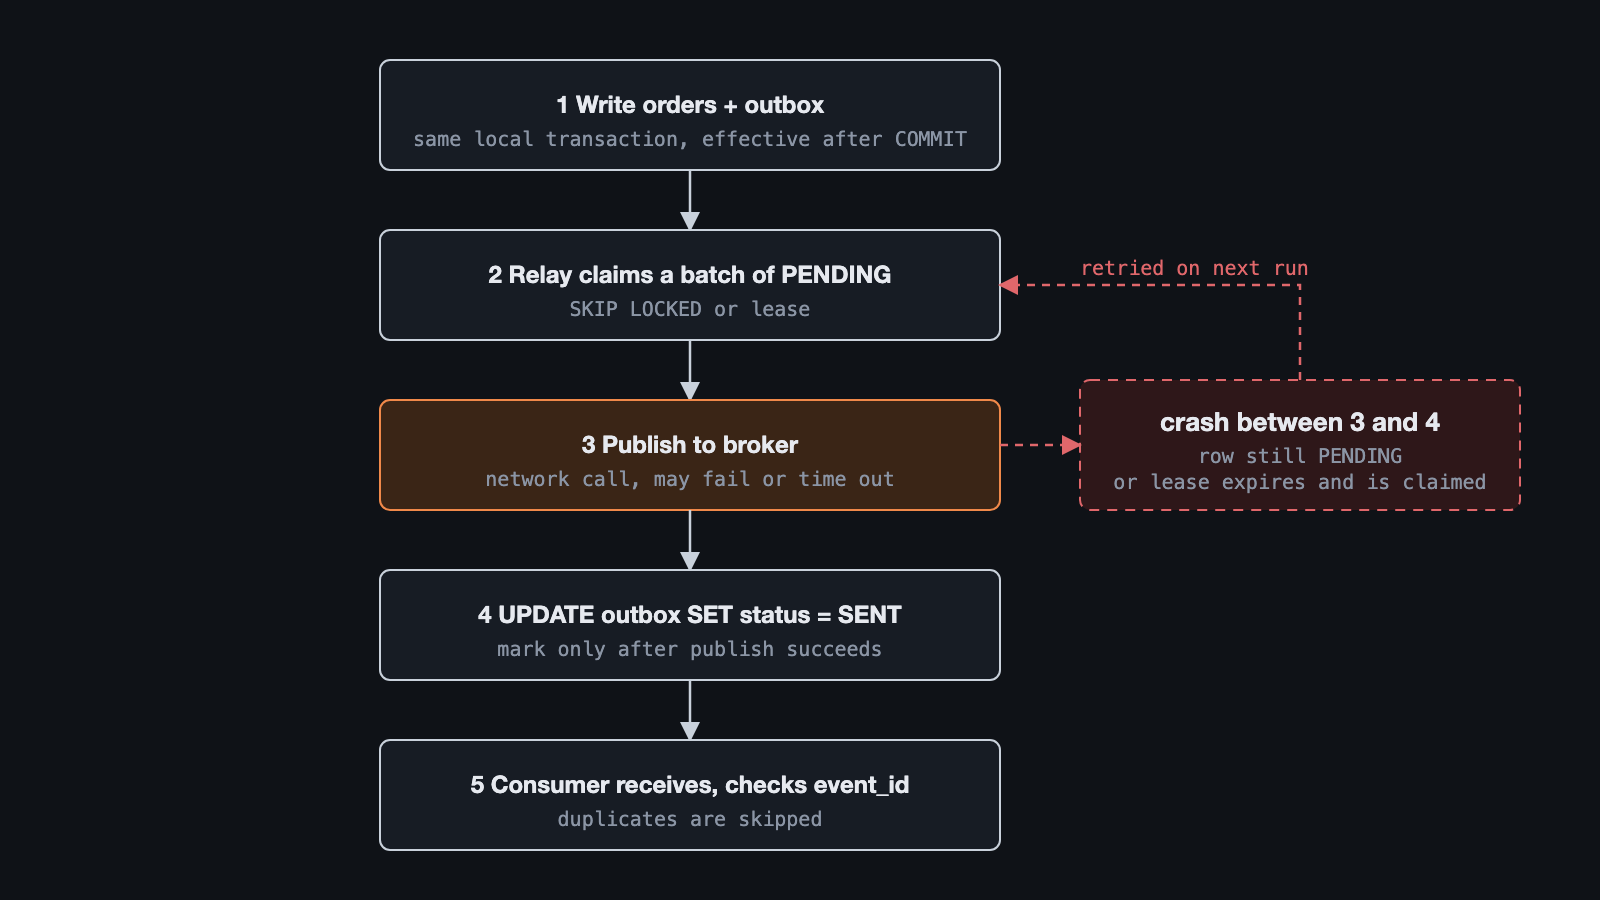
代價是:relay 可能在「發送成功」和「標記成功」之間掛掉,所以會重複發送。這就是前面說的 at-least-once,consumer 端必須是冪等的。
relay 之間不能搶同一批紀錄
relay 通常不會只跑一個。多個實例同時撈 PENDING,就會撈到同一批紀錄,事件被重複發送。這不是 at-least-once 的重送,而是可以避免的競爭。常見的解法有兩種。
做法一:FOR UPDATE SKIP LOCKED,在同一個 transaction 裡撈、發、標記:
 1BEGIN;
 2  SELECT id, type, payload
 3  FROM outbox
 4  WHERE status = 'PENDING'
 5  ORDER BY created_at
 6  LIMIT 100
 7  FOR UPDATE SKIP LOCKED;
 8
 9  -- 發送到 broker,成功後
10  UPDATE outbox SET status = 'SENT', sent_at = now() WHERE id = ANY($1);
11COMMIT;
被鎖住的列會被其他 runner 跳過。缺點是發送期間 transaction 一直開著,broker 慢的時候會佔住連線和鎖。
做法二:租約(lease),先把一批列「租」給某個 runner,發送完再標記,transaction 不需要跨越網路呼叫:
 1UPDATE outbox
 2SET locked_by = $1, locked_until = now() + interval '30 seconds'
 3WHERE id IN (
 4  SELECT id FROM outbox
 5  WHERE status = 'PENDING' AND (locked_until IS NULL OR locked_until < now())
 6  ORDER BY created_at
 7  LIMIT 100
 8  FOR UPDATE SKIP LOCKED
 9)
10RETURNING id, type, payload;
runner 掛掉的話,租約到期後其他 runner 可以接手。代價是租約到期時,原本的 runner 可能還在發送,於是出現重複,這同樣要靠 consumer 冪等來擋。
另外要注意順序。SKIP LOCKED 讓不同列可以被不同 runner 同時處理,同一個 aggregate 的事件可能亂序送出。如果下游依賴順序,就要按 aggregate_id 分區,或保證同一個 aggregate 同時只有一個在途事件。
套回 tool_call:intent 表
Outbox 套到 agent 身上,我會把它換個名字叫「intent 表」。核心想法是:不要讓 agent 直接呼叫外部工具,而是先把「我打算做這件事」寫進 DB,再由 executor 去執行。
 1CREATE TABLE tool_intents (
 2  idempotency_key TEXT PRIMARY KEY,  -- hash(run_id, step_id),不含 args
 3  run_id          TEXT NOT NULL,
 4  tool            TEXT NOT NULL,
 5  args            JSONB NOT NULL,
 6  args_hash       TEXT NOT NULL,     -- 重跑時用來比對 args 有沒有變
 7  risk            TEXT NOT NULL,     -- reversible | compensable | irreversible
 8  status          TEXT NOT NULL,     -- PLANNED | DISPATCHED | SUCCEEDED | FAILED | UNKNOWN
 9  external_ref    TEXT,              -- 外部系統回傳的識別碼
10  created_at      TIMESTAMPTZ NOT NULL DEFAULT now(),
11  updated_at      TIMESTAMPTZ NOT NULL DEFAULT now()
12);
幾個關鍵點:
idempotency_key是唯一的。同樣的 step 重跑,只會插入一次(INSERT ... ON CONFLICT DO NOTHING);如果 key 已經存在,代表這件事已經做過或正在做,直接讀取它的狀態。- key 不要包含 args。agent 重跑時,模型常常會產生稍微不一樣的 args,例如信件內容換了幾個字。如果 key 是用 args 算出來的,就會變成一個新 key,同一件事被做兩次。key 只用穩定的
run_id和step_id;同一個 key 的args_hash對不上,就當成衝突停下來,而不是當成新的請求。 - 狀態機要明確。
PLANNED → DISPATCHED → SUCCEEDED,失敗的話是FAILED,而最重要的是UNKNOWN:送出請求之後 timeout 了,我不知道對方有沒有執行。 DISPATCHED要先 commit 再呼叫。狀態沒有落地就先打出去,crash 之後 DB 還是PLANNED,系統會以為這件事沒做過。- 沒有冪等保證的
UNKNOWN不能自動重試。這是整個設計最關鍵的一條規則。重試一個可能已經成功的不可逆操作,就是重複扣款。
同樣的道理也適用於 executor 的租約。租約到期時,如果狀態還停在 DISPATCHED,代表那次呼叫的結果不明,應該轉成 UNKNOWN,而不是直接讓另一個 executor 重新發送。
要能處理 UNKNOWN,前提是第一次呼叫時,就把 idempotency_key 一起送給外部系統。外部系統支援冪等的方式大致有兩種:
- 由對方去重:例如 Stripe 的
Idempotency-Keyheader。帶同一個 key 重送,對方會回傳第一次的結果,不會再做一次。這種 API 的UNKNOWN可以直接重試,這正是這個機制存在的目的。 - 可以用 key 查詢:請求裡帶 client token 或 request id,之後可以拿它去查那筆操作的狀態。
第二種的處理順序是:
- 拿
idempotency_key去問外部系統。 - 查到成功,就把狀態更新為
SUCCEEDED,並記錄external_ref。 - 查到明確的失敗或不存在,而且確定原本的請求已經不會再生效(例如超過對方的處理期限),才能重新發送。只是「現在查不到」還不夠,原本的請求可能還在處理,或者對方的查詢結果有延遲。
- 無法確定、或外部系統兩種都不支援,就停下來交給人。
第四步就是金融系統裡「無法查詢時需要人工介入」的那一條。
Saga:用一連串的補償代替回滾
Saga 來自 Hector Garcia-Molina 和 Kenneth Salem 1987 年的論文〈Sagas〉,核心想法是:把一個長交易拆成一串本地交易 T1、T2、…、Tn,每個 Ti 都有一個對應的補償操作 Ci。 如果 Tk 失敗,就依序執行 C(k-1)、C(k-2)、…、C1,把已經做完的部分撤回。
這裡要注意一件事:補償不是回滾。 回滾是讓系統回到之前的狀態,好像什麼都沒發生過;補償則是再做一件新的事去抵銷前面的效果。在這中間,其他人可能已經看到過中間狀態。例如:
- 扣款成功,後來的步驟失敗,補償是退款。但這筆錢在退款前是真的被扣掉了,帳單上會看到兩筆。
- 建立了一個 PR,後來的步驟失敗,補償是把 PR 關掉。但通知可能已經發給 reviewer 了。
有兩種協調方式:
- Orchestration(編排):有一個中央的 orchestrator 決定下一步做什麼、失敗時怎麼補償。
- Choreography(編舞):各服務透過事件彼此觸發,沒有中央控制。
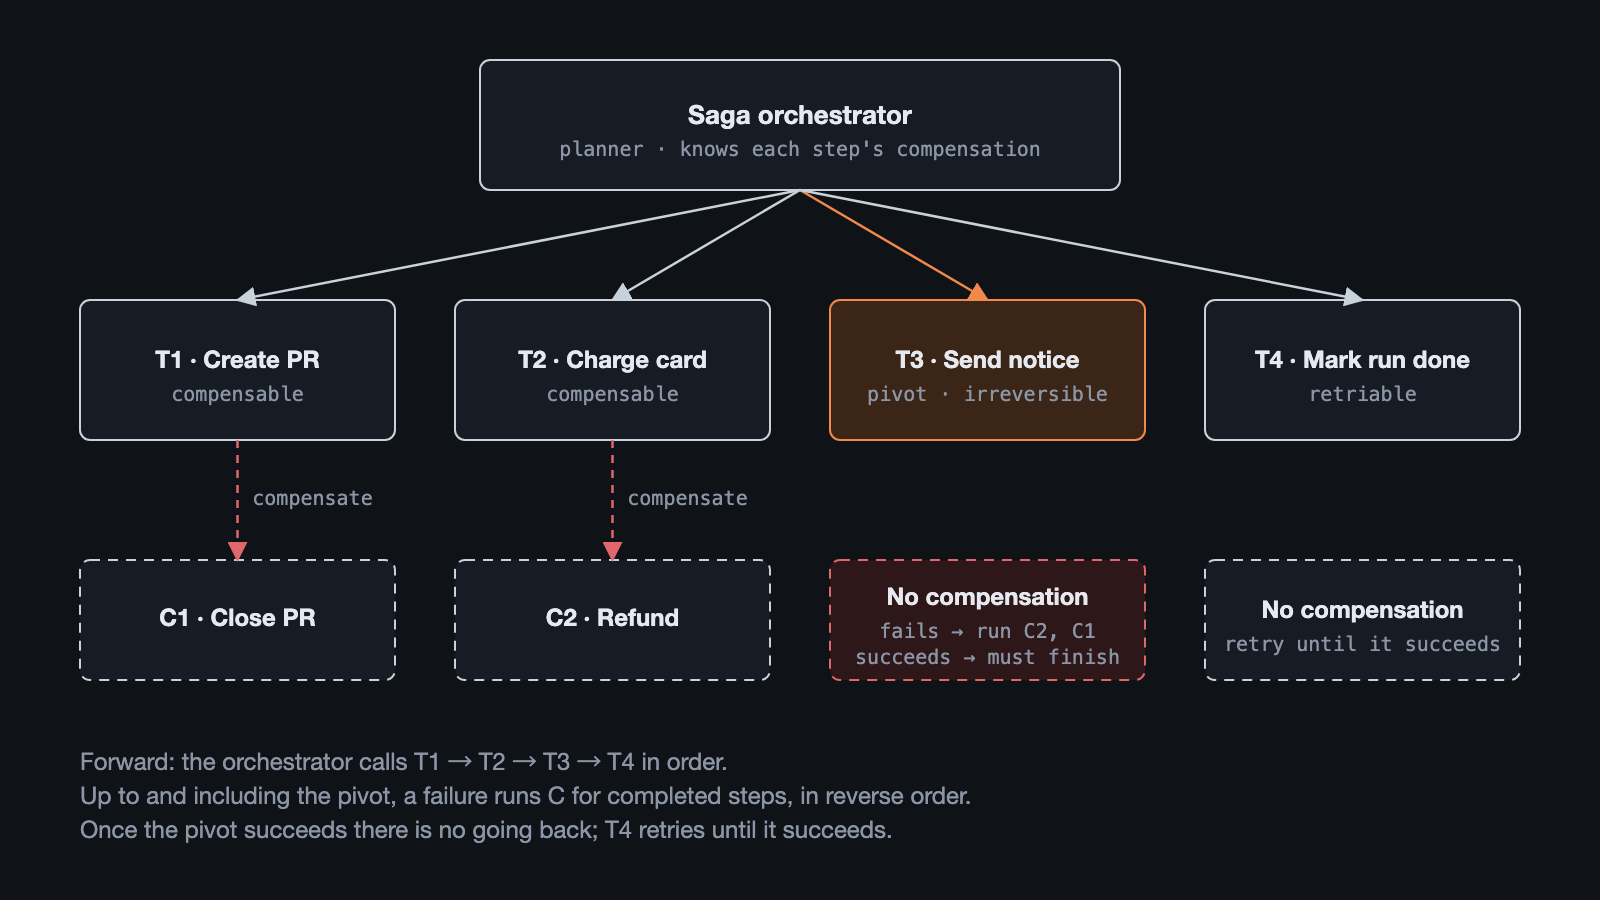
對 agent 來說,orchestration 比較自然。agent 的 planner 本來就是那個中央角色,它知道整個計畫、也知道每一步的補償是什麼。Choreography 在 agent 裡很難追蹤「現在到底跑到哪一步」,除錯會很痛苦。
Pivot transaction:過了就不能回頭的那一步
原始論文之後,實務上常把 saga 的步驟分成三種:可補償(compensable)、pivot、可重試(retriable),Chris Richardson 的《Microservices Patterns》就是這樣分的。其中最重要的是 pivot transaction,它是整條鏈上的分界點:
- pivot 之前的步驟,都可以補償。pivot 本身失敗的話,代表它沒有發生,一樣往回補償。
- pivot 一旦成功,就不能再回頭了。之後的步驟只能往前重試,直到成功為止。
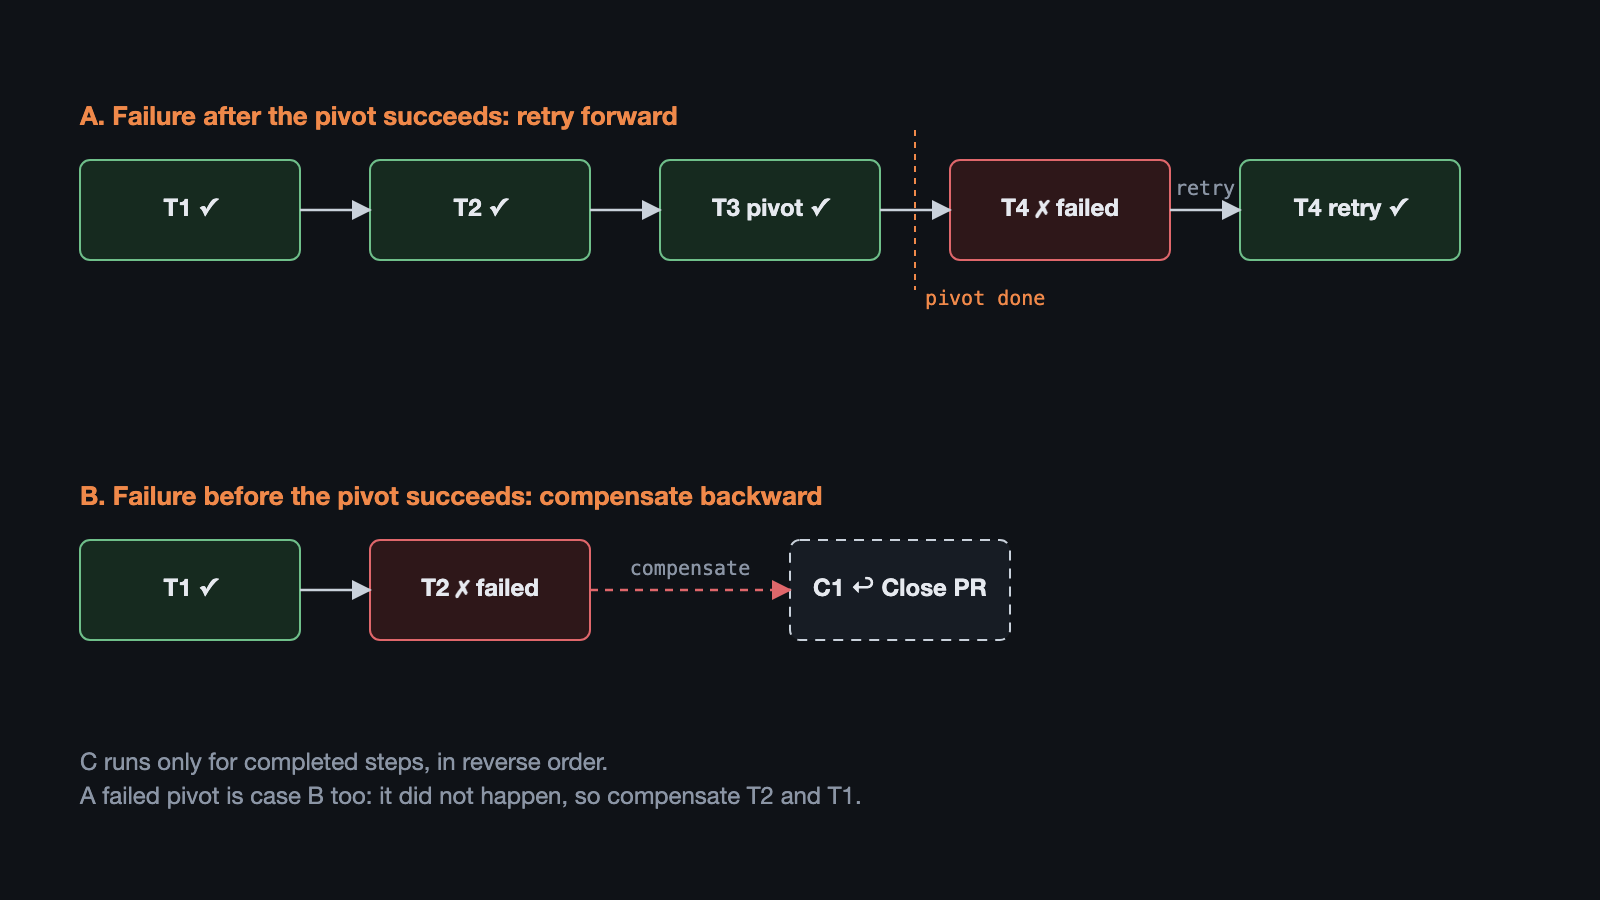
在 tool_call 的語境裡,pivot 通常就是那個不可逆的操作,例如真的寄出信、真的轉帳、真的刪除生產環境的資料。所以設計上我會建議:
- 把不可逆的操作放在鏈的最後,或者盡量往後放。能拆成 TCC 的就先拆:Try 放在前面當成可補償的步驟,Confirm 才是 pivot。
- pivot 之前設置 human gate。過了 gate,系統就只能往前走。
- pivot 之後的步驟,要設計成 retry-safe 的,因為它們只能一直重試到成功。
把工具依風險分級
前面這幾種 pattern 都要求我們先知道每個操作是什麼性質。我現在的做法是把工具分成三類:
| 類別 | 例子 | 失敗時怎麼辦 | 自動執行? |
|---|---|---|---|
| reversible | 寫入 scratch 目錄、本地的冪等編輯 | 直接丟掉重做 | 可以 |
| compensable | 開 PR(可關閉)、建立資源(可刪除)、扣款(可退款) | 執行補償 | 可以,但要記錄補償 |
| irreversible | 寄信、轉帳、刪除無備份的資料 | 無法補償,只能查詢或人工處理 | 必須有 human gate |
扣款和轉帳分在不同類,是因為卡片扣款通常可以退款,銀行轉帳出去之後卻往往沒辦法撤回。同一種「付錢」,要看底下的機制能不能補償。
分級的目的不是要讓系統完全不能做事,而是決定每一類要用多大的防護。
回到問題:怎麼把傷害降到最低
整理下來,要讓 agent 自動執行又不把風險放大,我的想法是這幾件事:
- 先 plan,再 apply。 任何會改變外部狀態的動作,先產出一份可以檢查的計畫(dry run),讓人或規則能看見它會做什麼。
- 限制爆炸半徑。 每次 run 能動的資源、金額、數量都要有上限,超過就停下來。
- 每個操作都有 idempotency key 和狀態機。 重試只會讀取狀態,不會重複執行。
- 不可逆操作前一定要有 gate。 這一步不能交給模型自己判斷。
- 沒有冪等保證的
UNKNOWN不自動重試。 先查、查不到就停,寧願慢也不要重複。 - 所有意圖和結果都寫下來。 這就帶出最後一個概念。
延伸:WAL 與 session log
WAL(Write-Ahead Log) 是資料庫最基本的設計:任何狀態改變之前,先把「我要做什麼」寫進 log。崩潰之後,系統可以從 log 重放,把狀態補回一致。前面的 intent 表就是同一個思路:先把 PLANNED 寫下來,再去執行。Outbox 則不太一樣,它是跟業務資料在同一個 transaction 裡一起寫,不算 write-ahead,但一樣是「先把意圖持久化,再讓別人去做」。
把這個概念套到 agent 上,就是 session log:
- 以 append-only 的方式,記錄每一個 turn、每一次 tool_call 的請求和回應。
- agent 崩潰或 timeout 之後,從 log 重建 context,讓它知道自己做到哪裡了。
- 關鍵規則:重放時只讀取已記錄的結果,不重新執行有副作用的 tool_call。 如果重放時又真的去寄一次信,那就是 WAL 設計失敗。
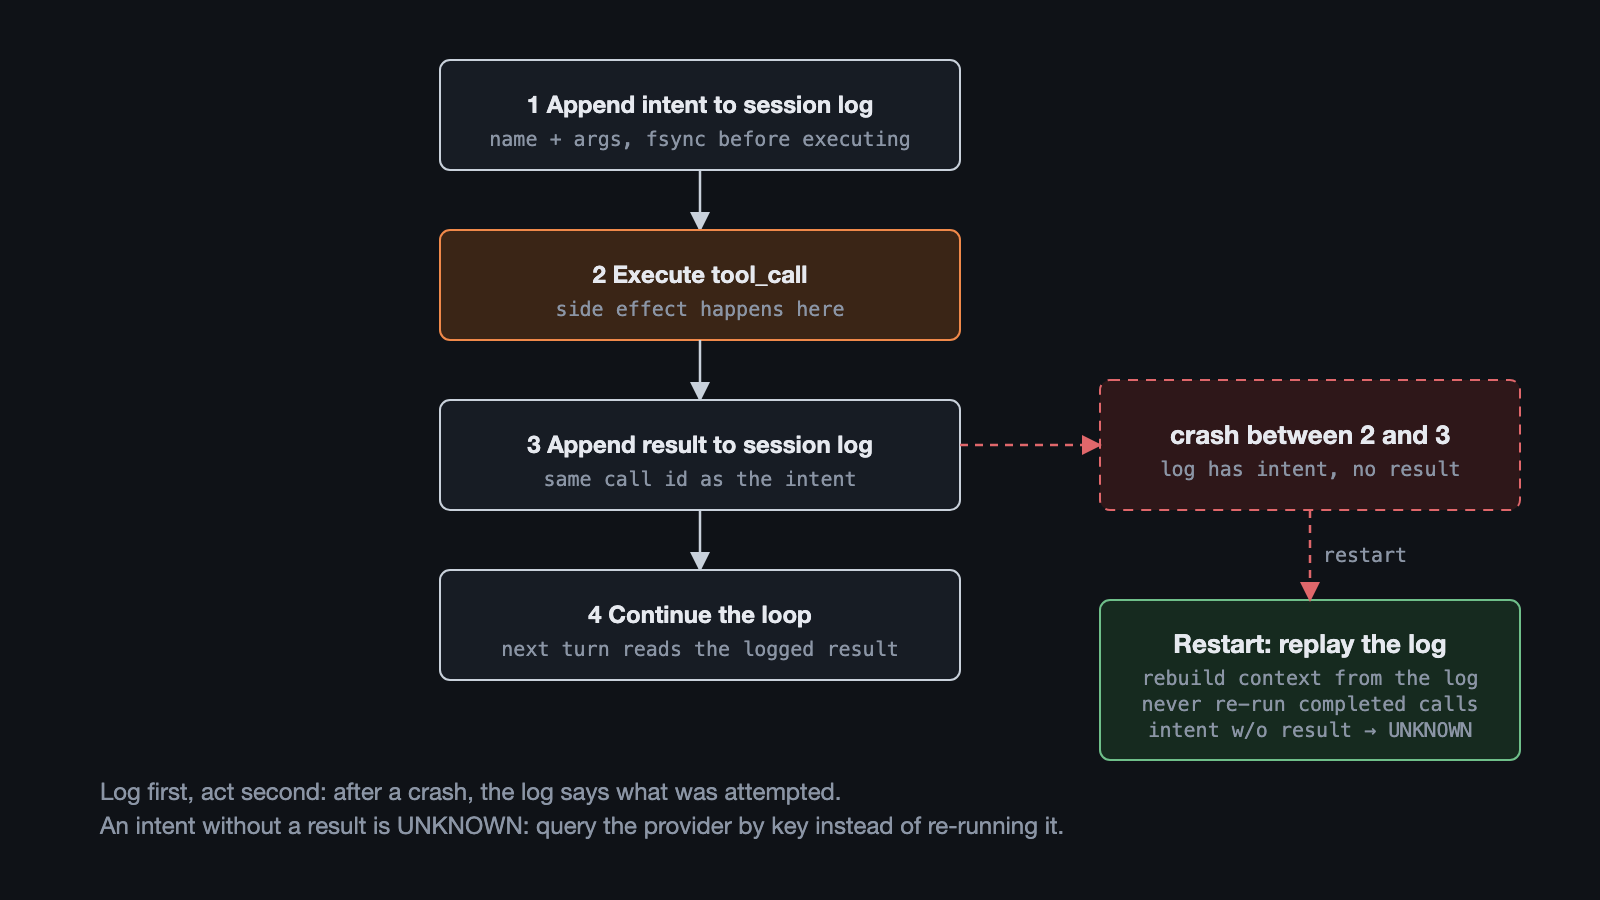
這樣一來,session log 同時解決了三個問題:除錯時可以看到完整的決策過程、崩潰後可以恢復、重試時可以判斷哪些步驟其實已經做過。
小結
回頭看,金融交易系統的那四件事,跟 agent 的 tool_call 幾乎一模一樣。這幾種 pattern 各自解決了一部分:
- 2PC 告訴我們原子性很珍貴,但外部 API 通常給不了 prepare,所以要把「決定」和「執行」拆開。
- TCC 在業務層自己做出 prepare,把不可逆的時間點縮到 Confirm 那一刻。
- Outbox 讓本地狀態和意圖保持一致,搭配冪等 key 和
UNKNOWN狀態,就能分辨哪些可以安全重試、哪些要先查。 - Saga 用補償取代回滾,並用 pivot 劃出不能回頭的那一步,把 human gate 放在它前面。
如果你也在做 agent 的 tool_call,我的建議是:先把工具分級,再為每一級決定 gate、重試和補償的方式。自動化本身不是問題,問題是在不可逆的那一步之前,有沒有人或規則替你把關。