
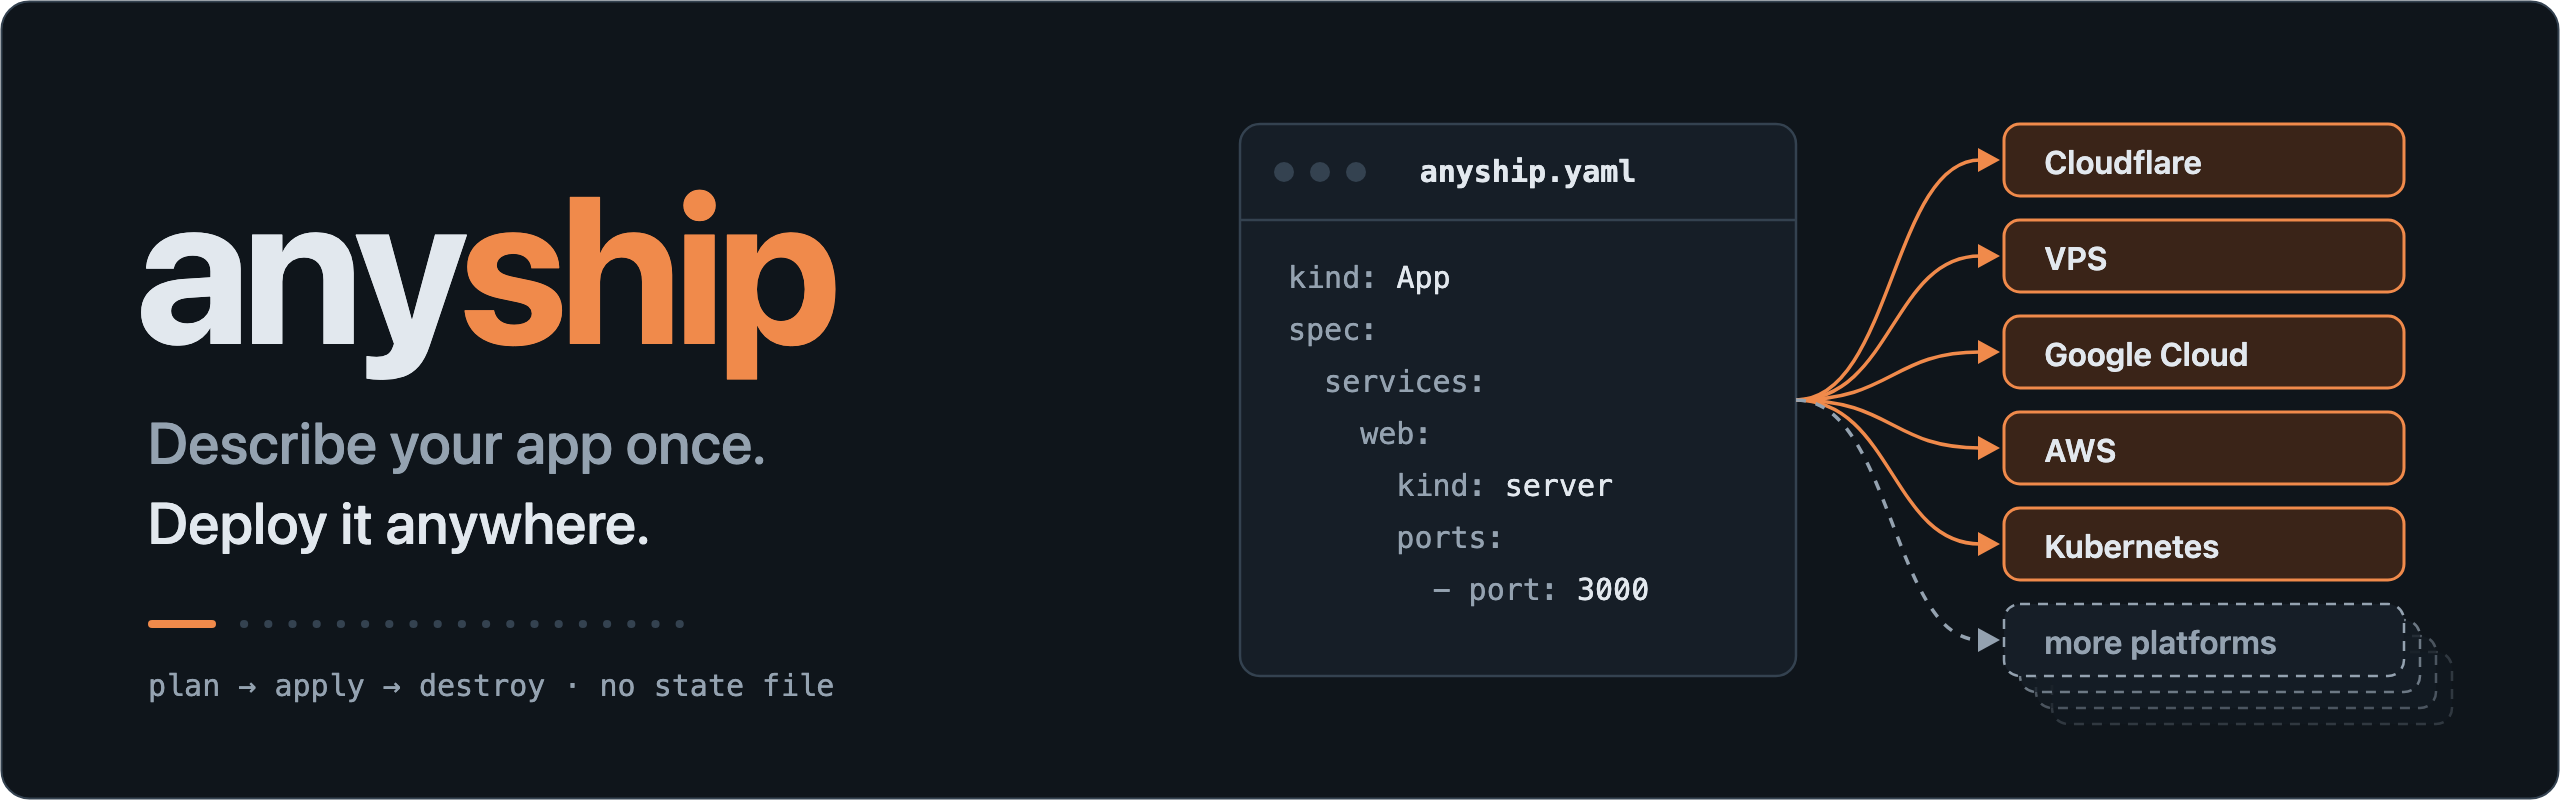
我手上有幾個小專案。為了省錢,哪裡便宜就放哪裡:edge handler 丟 Cloudflare Workers,web app 放 Cloud Run,要硬碟、要開 port 的節點跑在自己的 VPS,最近又多了一個 Kubernetes 叢集。每個專案都有自己的設定檔、自己的部署腳本、自己藏 secret 的方式。這樣搞了一年,我想要的其實很簡單:每個 app 只描述一次,然後用同一個指令,想部署到哪就到哪。 所以就有了 anyship。
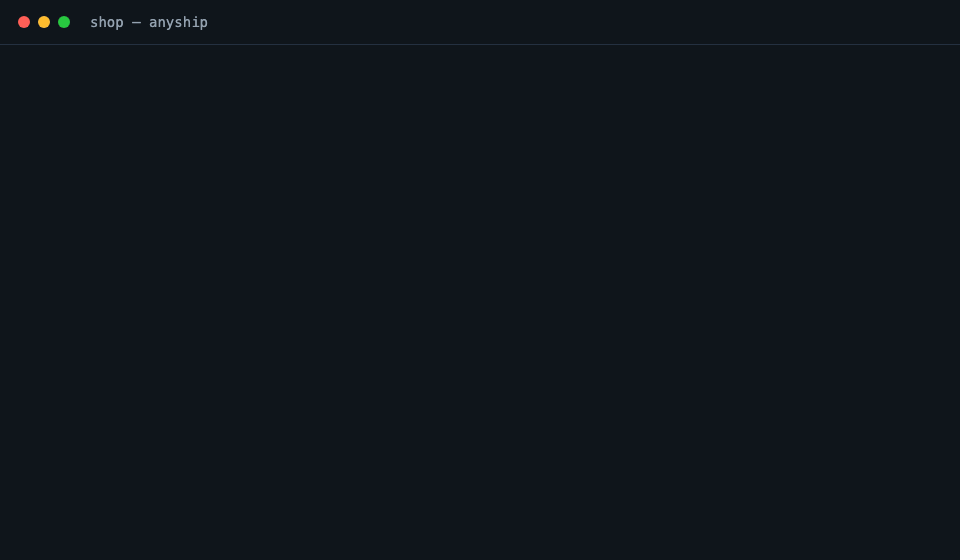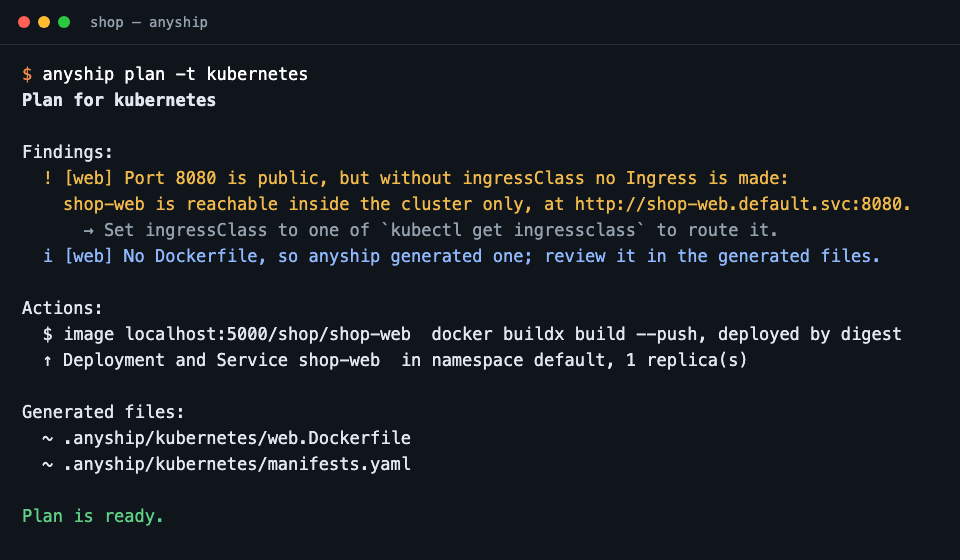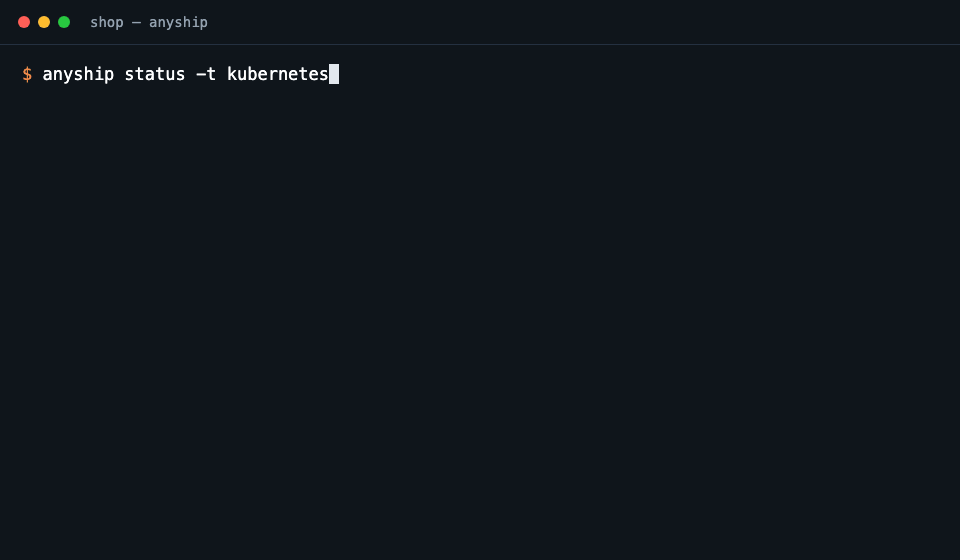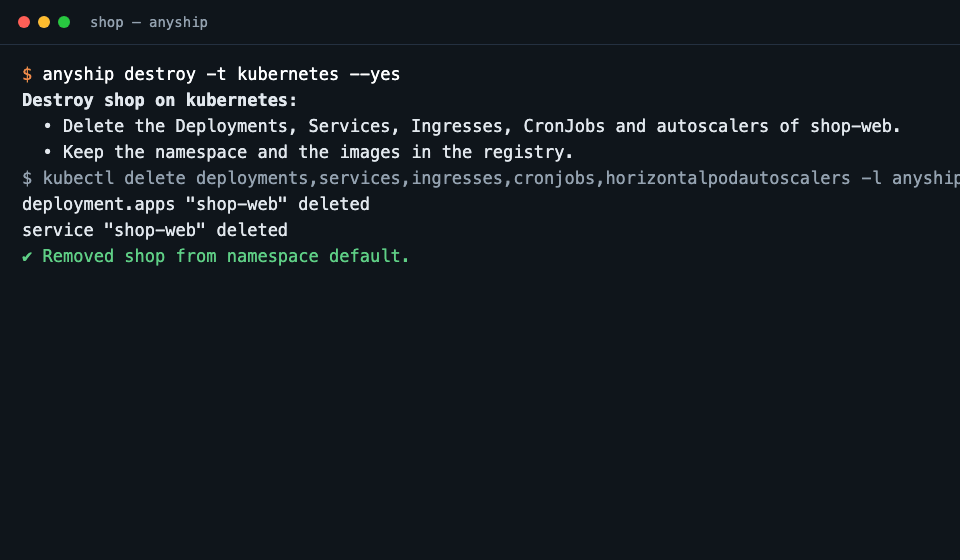
先看它長什麼樣子,從頭到尾部署到一個 Kubernetes 叢集:
痛點一:每個平台都有自己的一套設定
Workers 要 wrangler.jsonc,Cloud Run 要一堆 gcloud 參數,VPS 是 Compose 檔加 ssh,Kubernetes 又是另一套 manifest。同一個服務只要得在兩個地方跑,你就得養兩份長得差不多的設定,然後眼睜睜看著它們慢慢長歪。
anyship 只留一份 anyship.yaml。它寫的是這個 app 需要什麼,不是某個平台怎麼給:
 1apiVersion: anyship/v1alpha1
 2kind: App
 3metadata:
 4  name: shop
 5spec:
 6  services:
 7    web:
 8      kind: server
 9      start: node dist/server.js
10      memory: 512MB
11      ports:
12        - port: 3000
13      secrets: [JWT_SECRET]
14      cron:
15        - schedule: "0 * * * *"
16          path: /tick
17  targets:
18    kubernetes: {namespace: shop, repository: ghcr.io/me/shop}
19    gcp: {project: my-project, region: asia-east1}
跑 anyship apply -t kubernetes,它變成 Deployment、Service、Secret 加一個 CronJob;跑 anyship apply -t gcp,同一份檔案變成 Cloud Run service、Secret Manager 的 secret 和一個 Cloud Scheduler job。平台專屬的東西,像 namespace 或 registry,全部關在 targets 底下,其他地方看不到。
痛點二:平台不會先告訴你的那些事
以前最花時間的就是這塊。Cloud Run 預設的 request timeout 對排程端點來說太短,得自己設;Kubernetes 上開一個公開 port,沒有 Ingress 之前其實只有叢集裡面連得到;volumes 一寫下去,就只能單副本加 Recreate 滾動,不然兩個 pod 會搶同一顆硬碟。這些都不算設定寫錯,是平台覺得你本來就該知道。
anyship 的做法是一條規則,我叫它 refuse, don’t drop:在任何東西真的跑之前,plan 先把這個 target 做不到的、或會用你沒想到的方式做的需求,一條一條講出來。每條都有固定的代碼和一句提示:
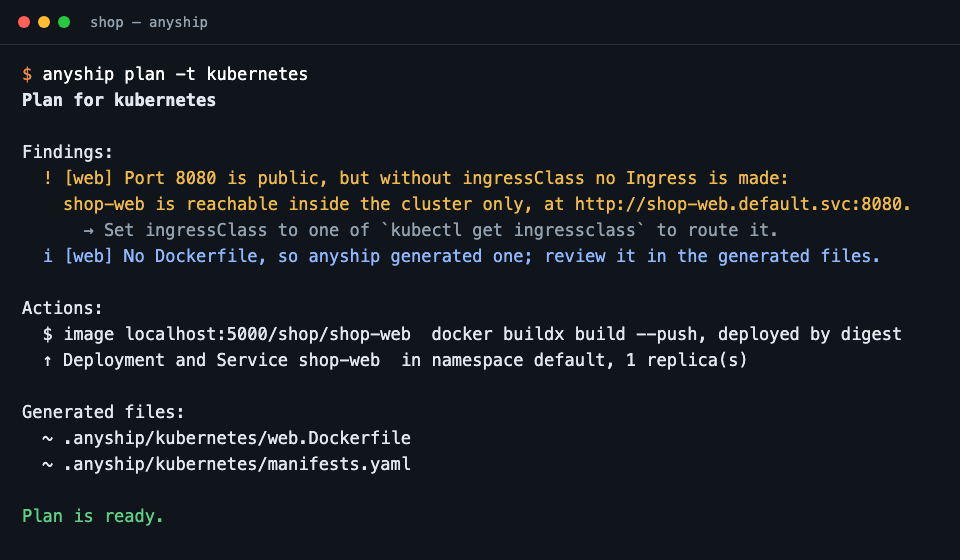
target 不會偷偷降級。spec 要的它做不到,就直說,然後這份 plan 就不會被 apply。每個平台的警告讀起來都是同一種格式,所以我在 Cloud Run 上踩過的坑,現在是輸出裡的一行字;換到下一個平台,它也會有自己的那一行。
至於真正屬於基礎設施的東西,我刻意留在外面。Firestore 的 index、bucket、Scheduler 用的 service account,這些在 app 出現之前就該存在了,anyship 只用名字去綁,不幫你建。我自己的 cuesocial(一個排程發 Threads 和 Instagram 的小工具)到現在還留著一支 setup-gcp.sh,做的就只有這些事。
痛點三:image 版本和 secret,每個平台各玩各的
我希望每次部署跑的,就是它剛剛建好的那個 image。anyship 用 docker buildx 建好、推上去,然後用 digest 部署;spec 裡要是寫了 latest 這種會跑掉的 tag,它會提醒你。secret 只用名字宣告一次,每個 target 存在自己該存的地方(Secret Manager、Secrets Manager、掛成檔案的 Kubernetes Secret、主機上的檔案),之後再用那個名字找回來。spec 裡從頭到尾不會出現值。
那為什麼不用 Terraform?
因為我不需要建基礎設施,伺服器、DNS、資料庫早就都在了。我要的只是把應用放上去,然後在每個地方用同一套方式操作它。對這件事來說,Terraform 的 state 檔是多出來的負擔:要存、要鎖、還要對帳。
anyship 完全不存狀態。它建的每個物件都照 spec 命名、貼上專案標籤,所以 status、logs、destroy 做的事就只是問平台「現在有什麼」。兩台機器可以操作同一個部署,也不會不同步,因為根本沒有東西可以不同步。
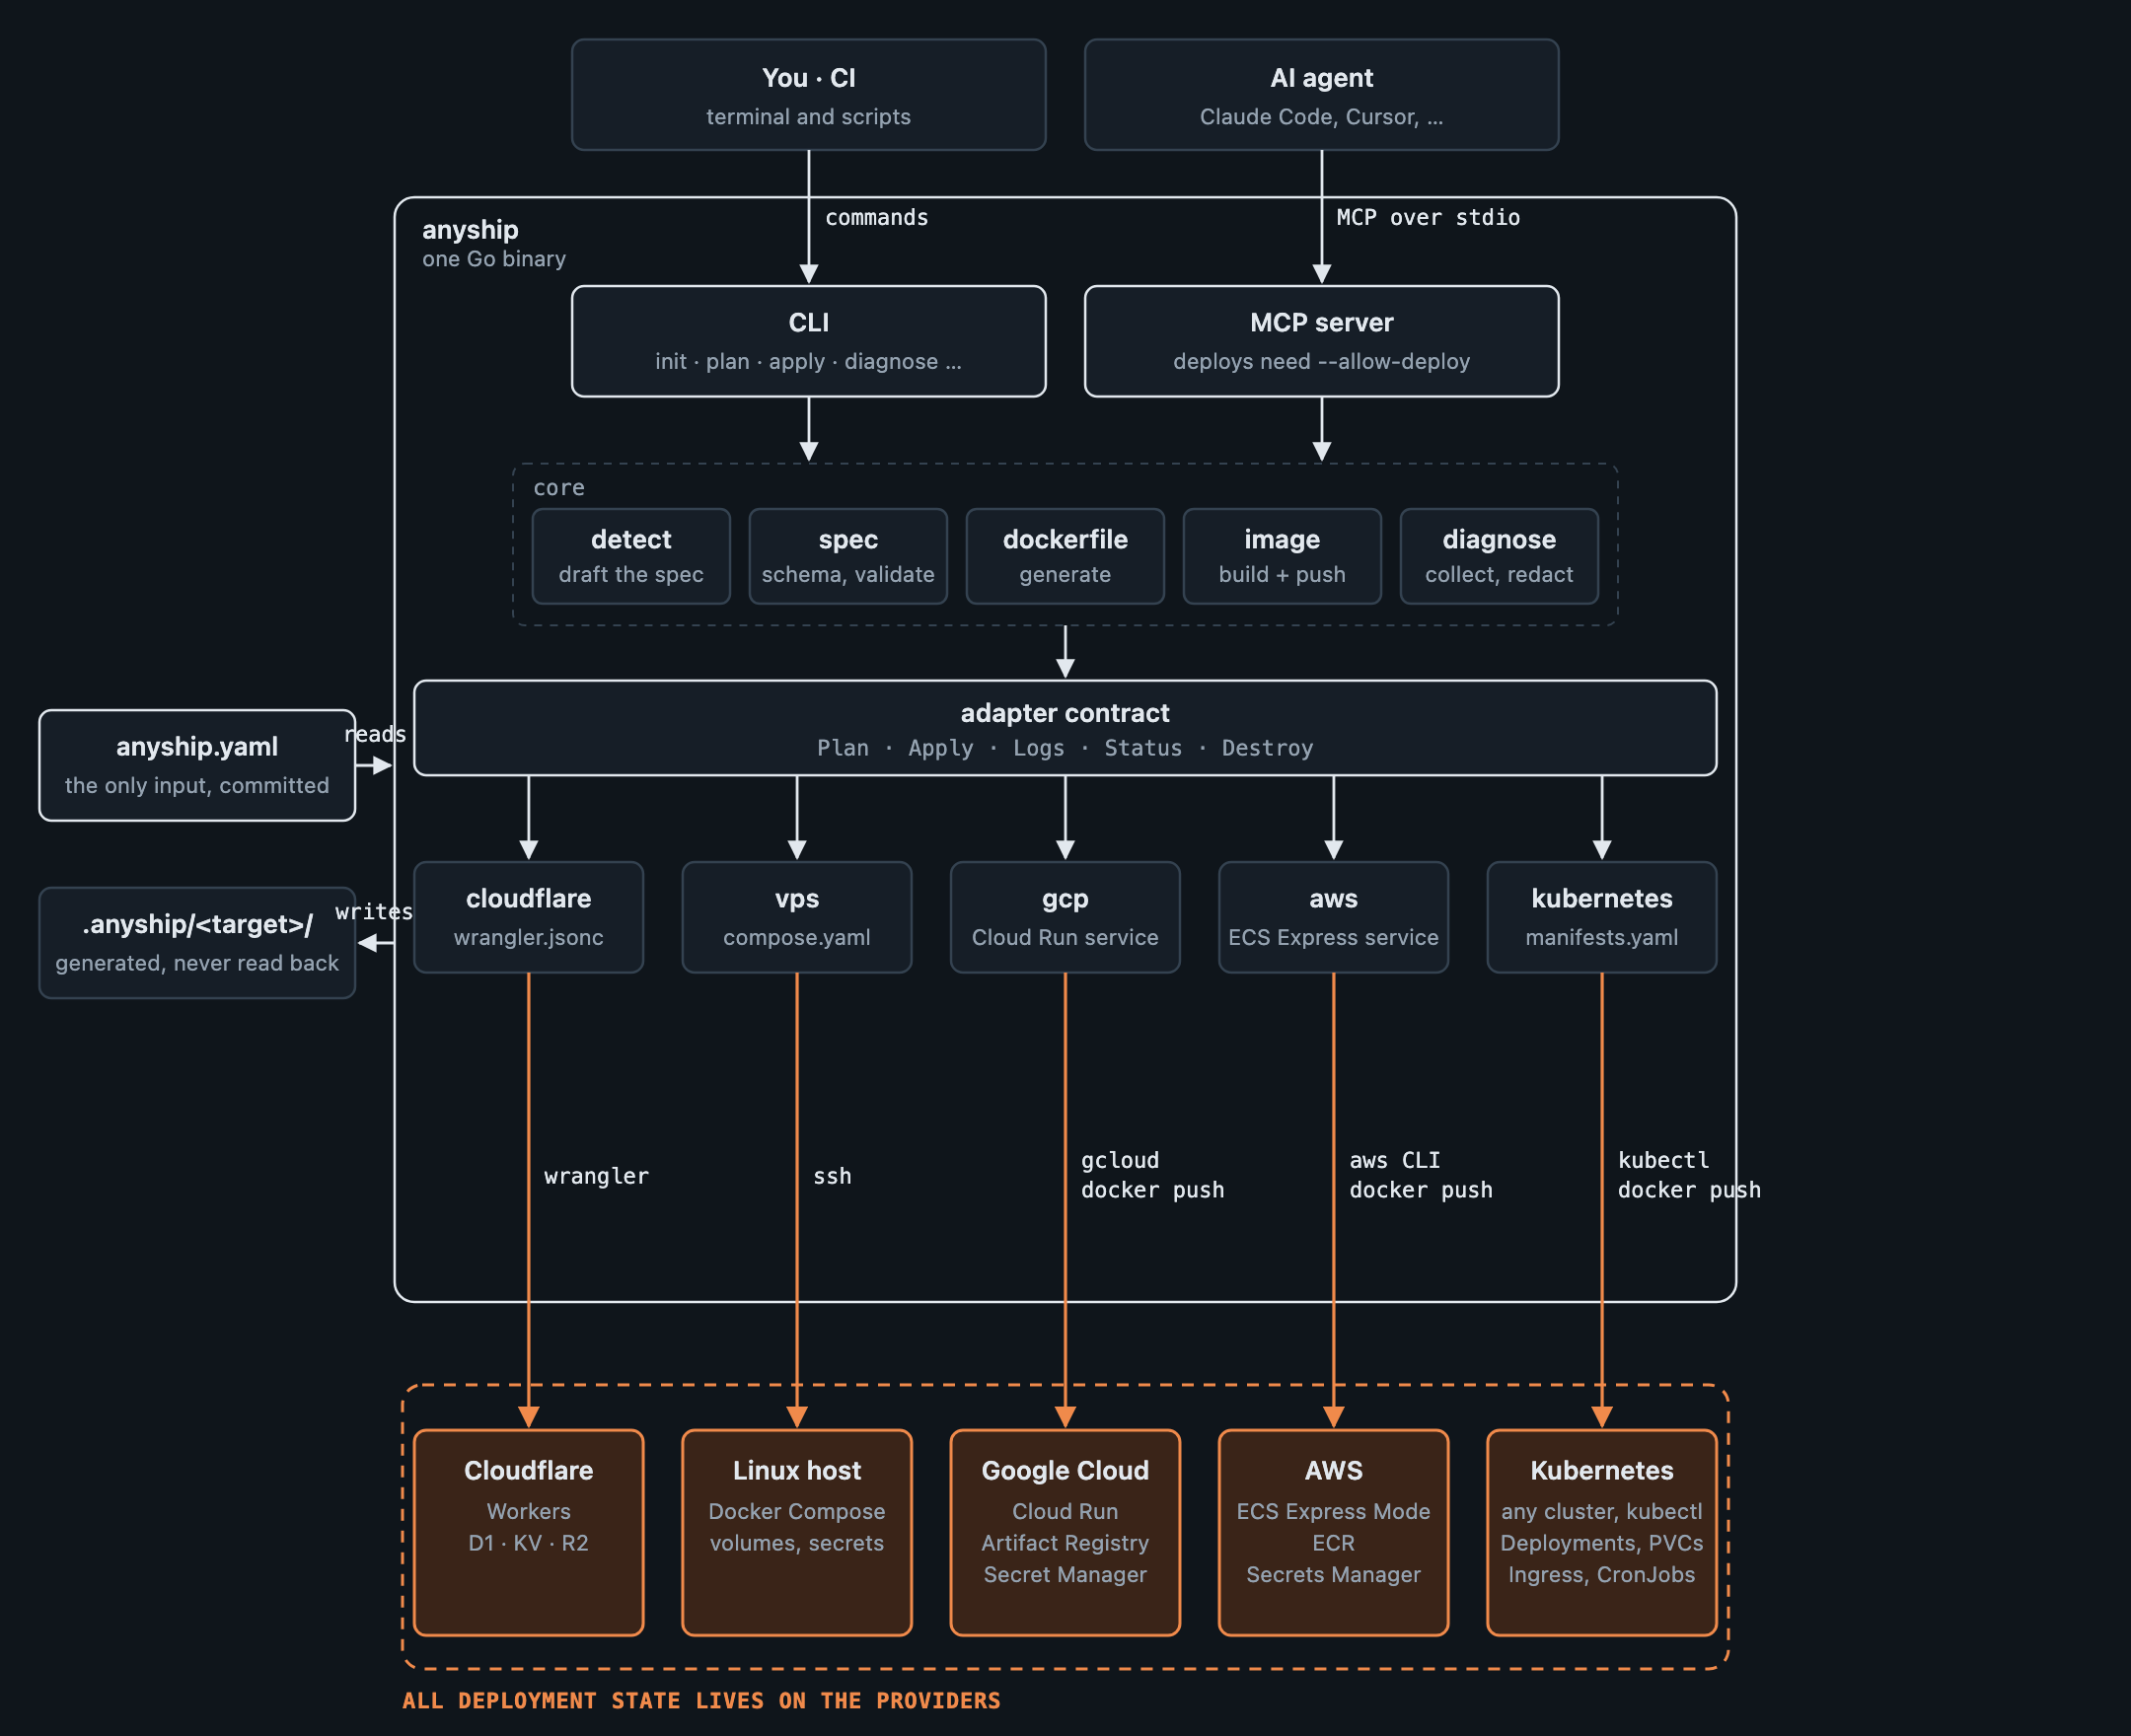
它就是一個 Go binary,沒有伺服器、沒有雲端 SDK。每個 adapter 呼叫的都是你早就裝好的工具,wrangler、ssh、gcloud、aws、kubectl,用的也是你自己的登入。anyship 手上不會有任何憑證。
給 agent 用的,也是同一套
部署變成一套介面之後,讓 agent 來用幾乎是順便的。anyship 內建 MCP server,每個指令也都有 --json,兩邊是同一組型別長出來的,所以 agent 不管從哪邊進來,看到的東西都一樣:
1claude mcp add anyship -- anyship mcp        # plan、dry run、status、logs
2claude mcp add anyship -- anyship mcp --allow-deploy   # 也允許真的部署
安全這件事放在工具裡,不靠 agent 自己判斷:
- 沒加
--allow-deploy的 MCP server 只能 plan 和 dry run,真的要部署、要刪,得加這個旗標。 - 要刪資料,必須把專案名稱用
confirm_project傳回來。 plan、status、logs這些唯讀工具不會動你的專案,host 可以放心不用每次都問。
部署失敗的時候,anyship diagnose 自己不會去呼叫任何模型。它只是把脫敏過的全貌交給你的 agent:spec、plan 的 findings、dry run 的檢查、status、最近的 logs、產生的檔案。agent 提出來的修法,就是改一次 anyship.yaml,跟你自己改一樣要過 plan。AI 可以幫我寫 spec、幫我看失敗原因,但不會站在部署路徑上。最後上線的,一定是我自己看過的那份檔案。
試試看
anyship 還在開發中(現在 v0.6),spec 和指令都有可能再改;每個 target 驗證到哪裡,README 寫得很清楚。如果你的專案也是這樣東一個西一個,挑一個試試:
1curl -fsSL https://raw.githubusercontent.com/j75689/anyship/main/install.sh | sh
2cd your-app && anyship init && anyship plan -t <target>
plan 什麼都不會動,最壞的情況就是拿到一張「這個 target 還做不到什麼」的清單。清單上要是有你需要的,開個 issue 跟我說;想自己動手的話,PR 直接來,很歡迎。